【大模型2609·数据结构算法·08】检索与排序全景:二分查找与六大经典排序算法剖析
【大模型2609·数据结构算法·08】检索与排序全景:二分查找与六大经典排序算法剖析
kikock专栏导读:面试与工程中最核心的基本功。本篇全景拆解二分查找边界陷阱与摩尔投票法找多数元素;系统剖析六大经典排序算法的稳定性、就地性与最坏/平均时空复杂度:冒泡、选择、插入,以及 O(NlogN) 的三大主力军——归并排序、快速排序(双指针划分)与堆排序(完全二叉树堆化)。
常用算法
查找算法
二分查找
算法原理
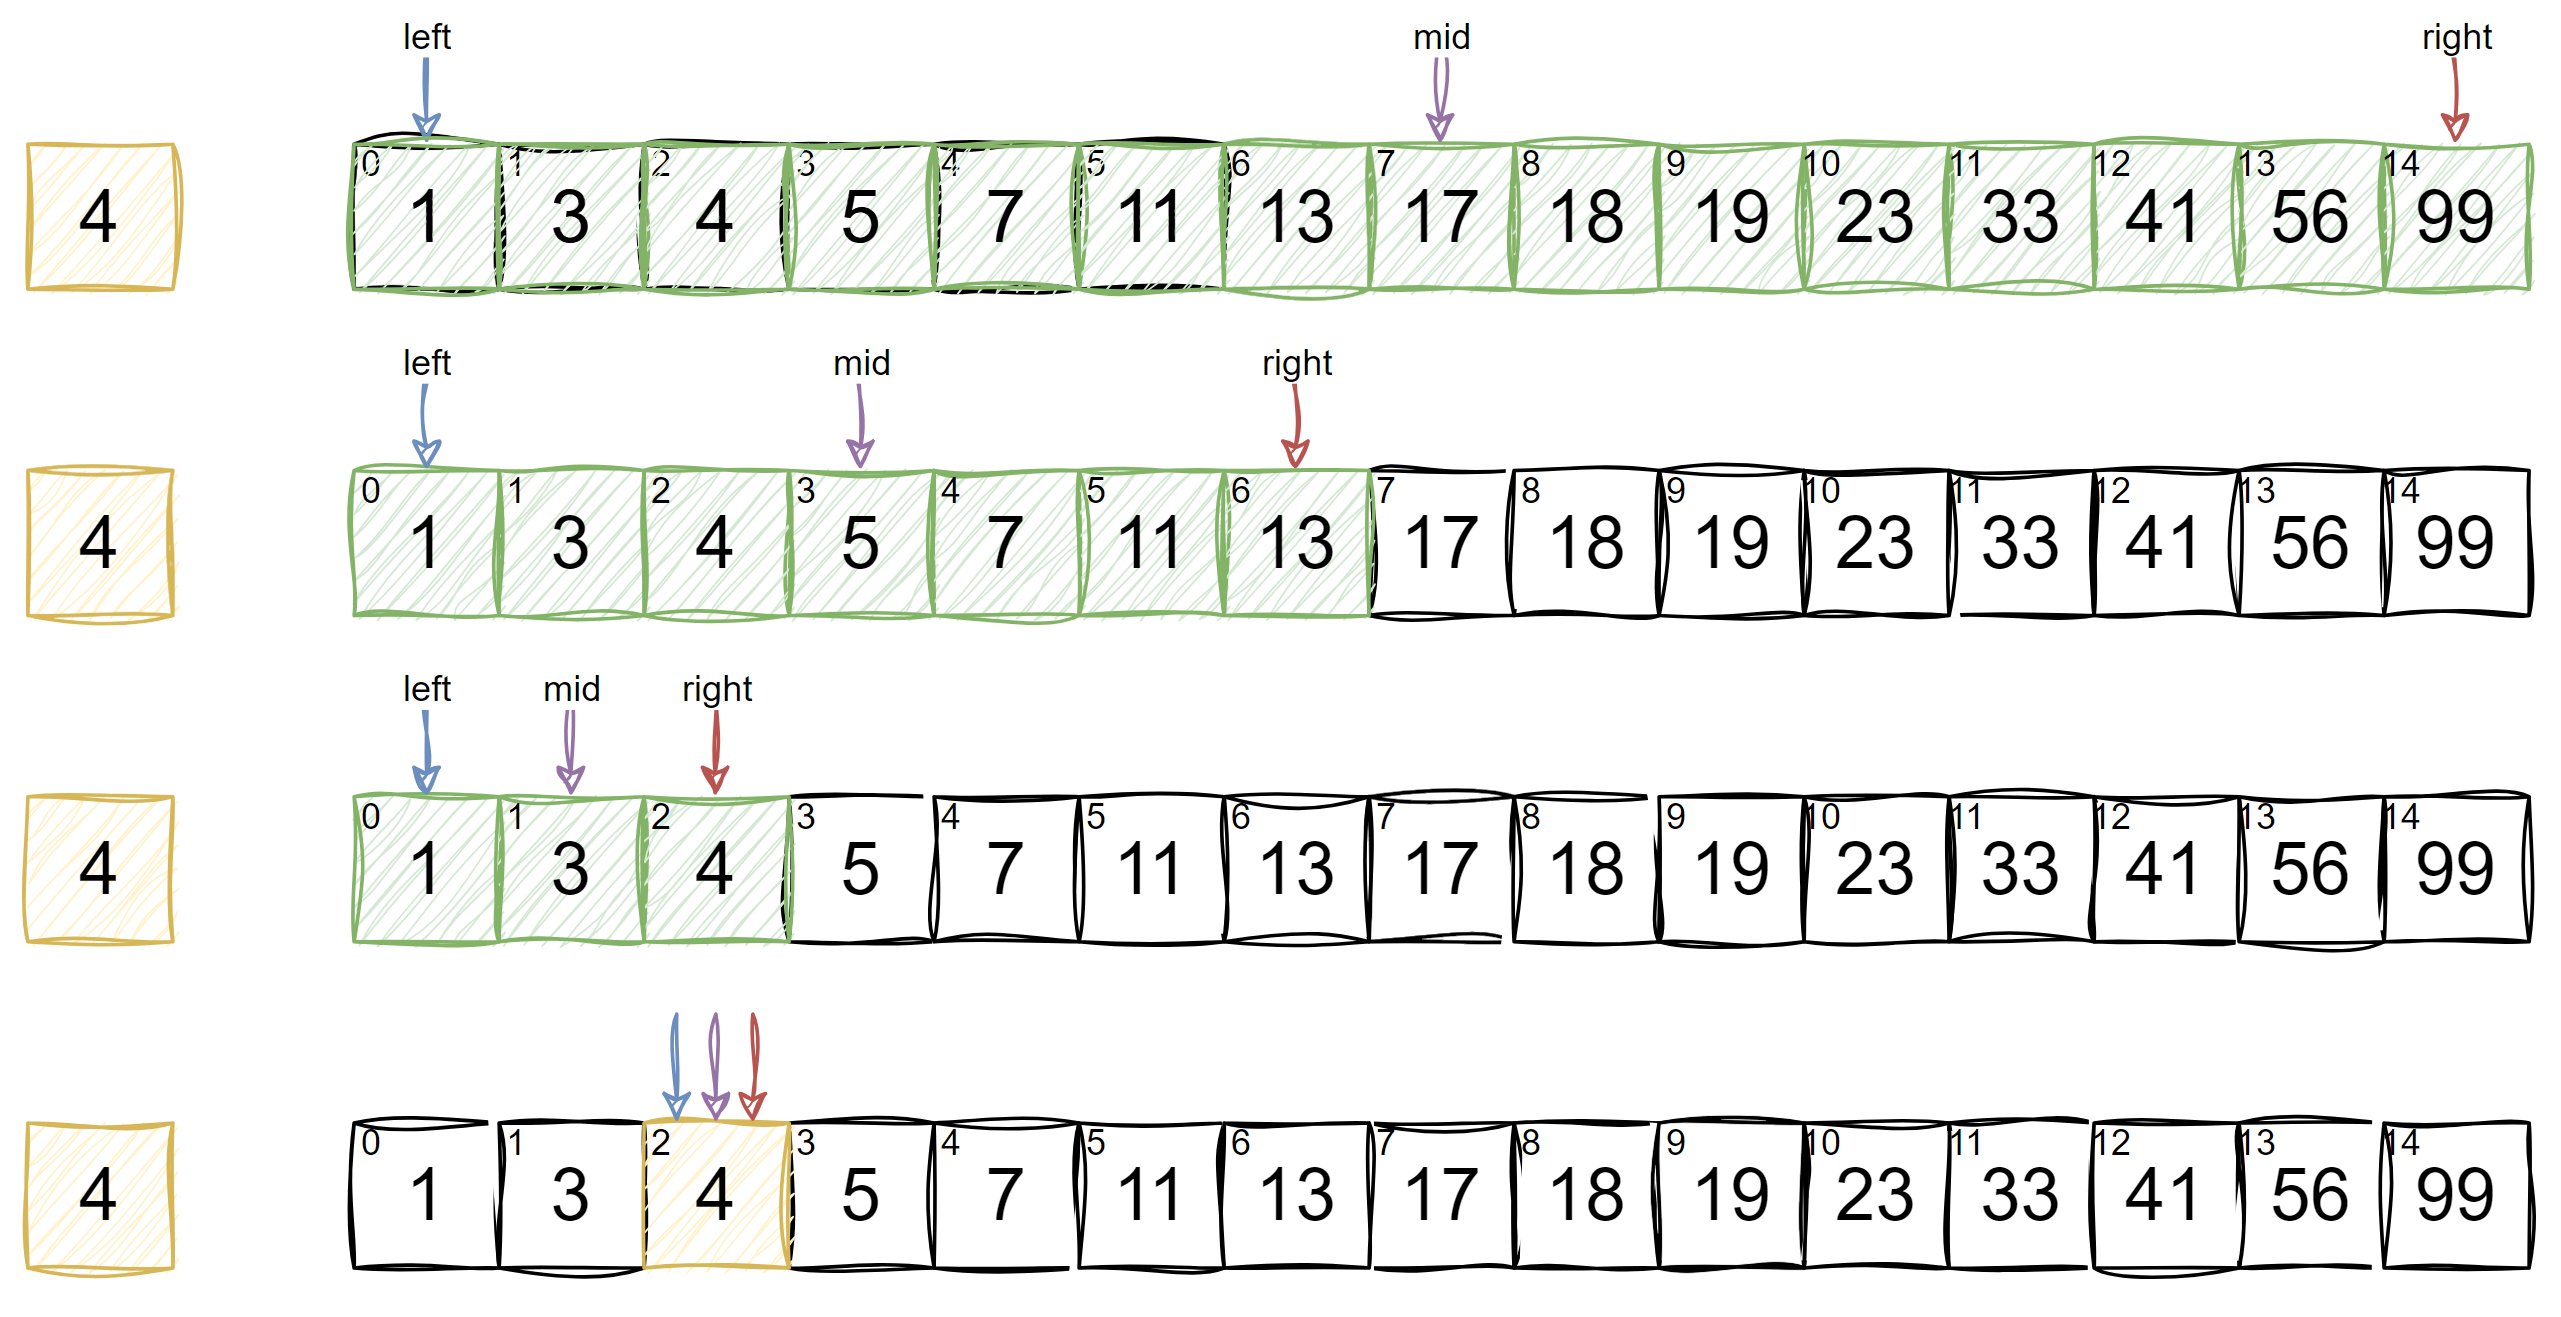
二分查找又称折半查找,适用于有序列表。其利用数据的有序性,每轮缩小一半搜索范围,直至找到目标元素或搜索区间为空为止。
代码实现
1 | def binary_search(arr, target): |
复杂度分析
时间复杂度
在循环中,区间每轮缩小一半,因此时间复杂度为O(logn)。
空间复杂度
使用常数大小的额外空间,空间复杂度为O(1)。
查找多数元素
力扣169题https://leetcode.cn/problems/majority-element/description/
返回数组中数量超过半数的元素,要求时间复杂度O(n)、空间复杂度O(1)。
示例:
输入:nums = [2,2,1,1,1,2,2]
输出:2
思路分析
为了严格符合复杂度要求,可以使用多数投票算法,多数投票算法也叫摩尔投票算法。摩尔投票算法的核心思想是对立性和抵消,它基于这样一个事实:如果一个元素在数组中出现的次数超过数组长度的一半,那么在不断消除不同元素对的过程中,这个多数元素最终会留下来。
具体来说,算法维护两个变量:一个是候选元素 candidate,另一个是该候选元素的计数 count。在遍历数组的过程中,遇到与候选元素相同的元素时,计数加 1;遇到不同的元素时,计数减 1。当计数减为 0 时,说明当前候选元素被抵消完,需要更换候选元素为当前遍历到的元素,并将计数重置为 1。
算法步骤
初始化:
选择数组的第一个元素作为初始候选元素 candidate。
将计数 count 初始化为 1。
遍历数组:
从数组的第二个元素开始遍历。
若当前元素与候选元素相同,count 加 1。
若当前元素与候选元素不同,count 减 1。
当 count 变为 0 时,将当前元素设为新的候选元素,并将 count 重置为 1。
返回结果:
遍历结束后,candidate 即为多数元素。
代码实现
1 | def majorityElement(nums): |
排序算法
冒泡排序
算法原理
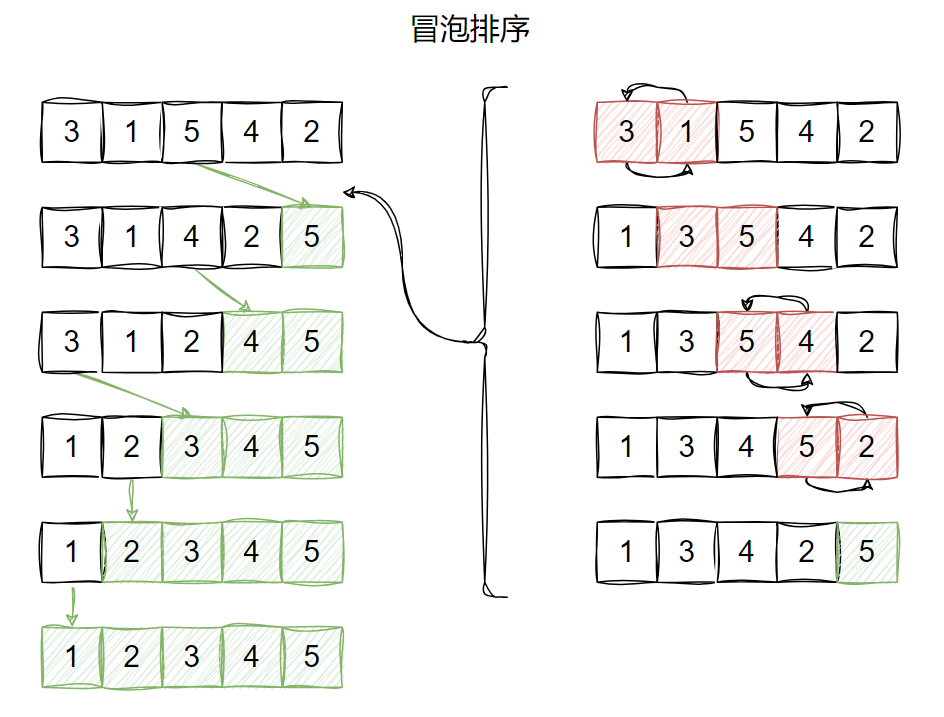
将待排序数组分为无序区间和有序区间两部分,无序空间在前,有序空间在后。起初,数组中的所有元素均位于无序区间。冒泡排序算法的宏观思路是,逐个将无序区间中的最大值冒出到末尾(最大值到末尾之后就相当于进入了有序区间)。直到无序区间的所有元素都冒出到有序区间。
冒出最大值的微观逻辑是两两比较并交换,从无序区间的第一个元素开始,将其与后一个相邻元素行进比较,若当前元素较大,则交换到下一个元素的位置。然后继续比较第二个元素和下一个相邻元素,直至无序区间末尾。这样一来,每经历一轮冒泡操作,都会将现有无序区间中的最大值冒出到有序区间。
代码实现
1 | def bubble_sort(nums): |
复杂度分析
时间复杂度
上述算法共执行 (n-1) + (n-2) + (n-3) + … + 3 + 2 + 1 = 轮循环,每轮循环都执行常量个基本指令,时间复杂度为O(n2)。
空间复杂度
就地排序,使用常数大小的额外空间,空间复杂度为O(1)。
选择排序
算法原理
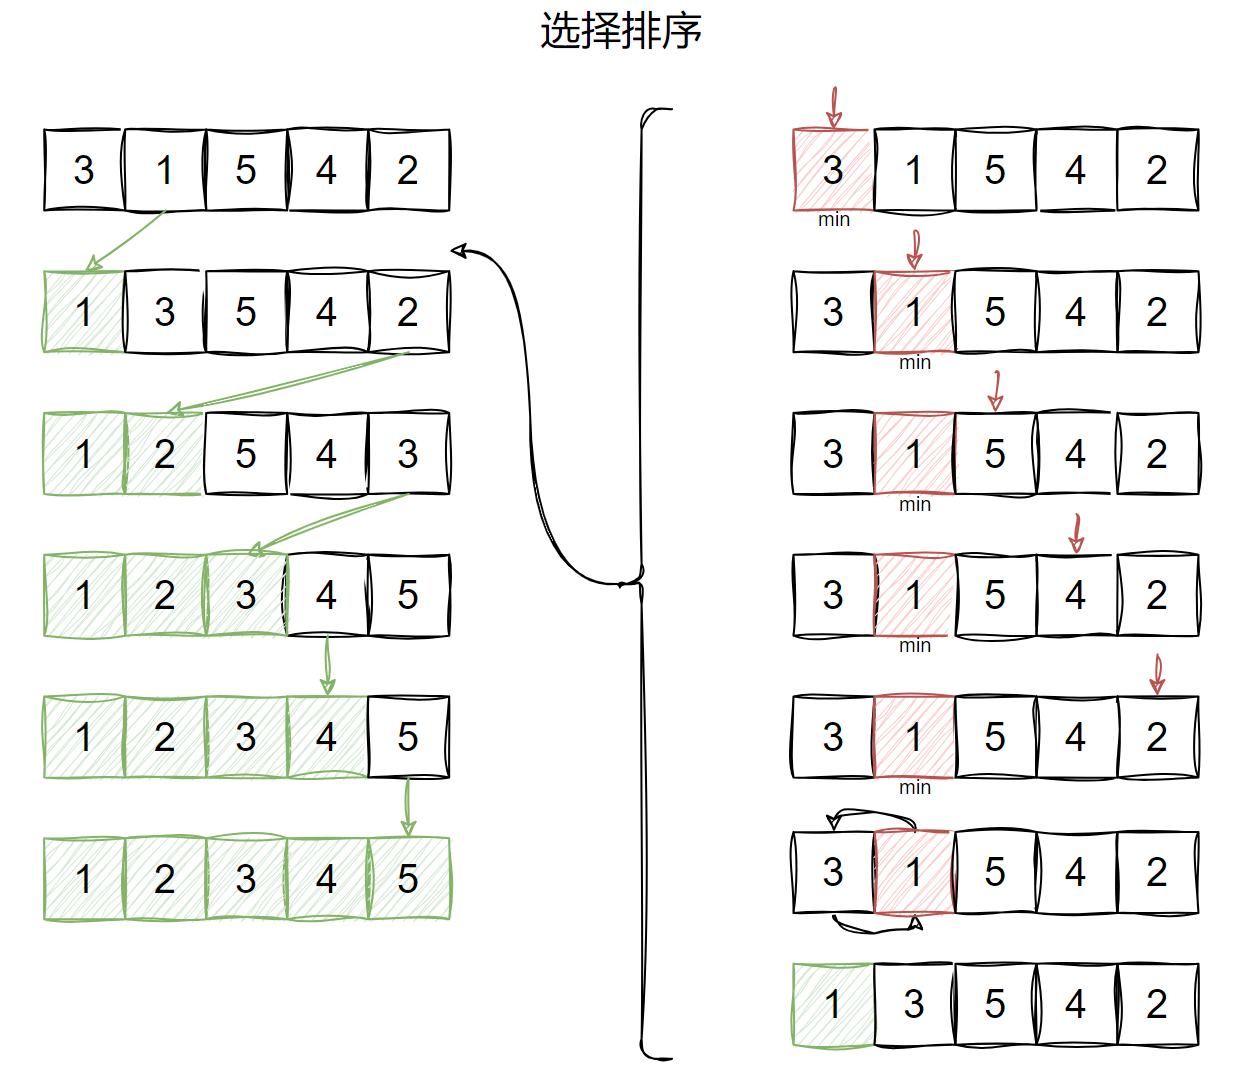
将待排序数组分为无序区间和有序区间两部分,有序空间在前,无序空间在后。起初,所有元素均位于无序区间。选择排序算法的思路是依次在无序区间中遍历找到最小元素,然后将最小元素与无序区间中的第一位进行交换,使最小元素并入有序区间。
代码实现
1 | def select_sort(nums): |
复杂度分析
时间复杂度
上述算法共执行 (n-1) + (n-2) + (n-3) + … + 3 + 2 + 1 = 轮循环,每轮循环都执行常量个基本指令,时间复杂度为O(n2)。
空间复杂度
就地排序,使用常数大小的额外空间,空间复杂度为O(1)。
插入排序
算法原理
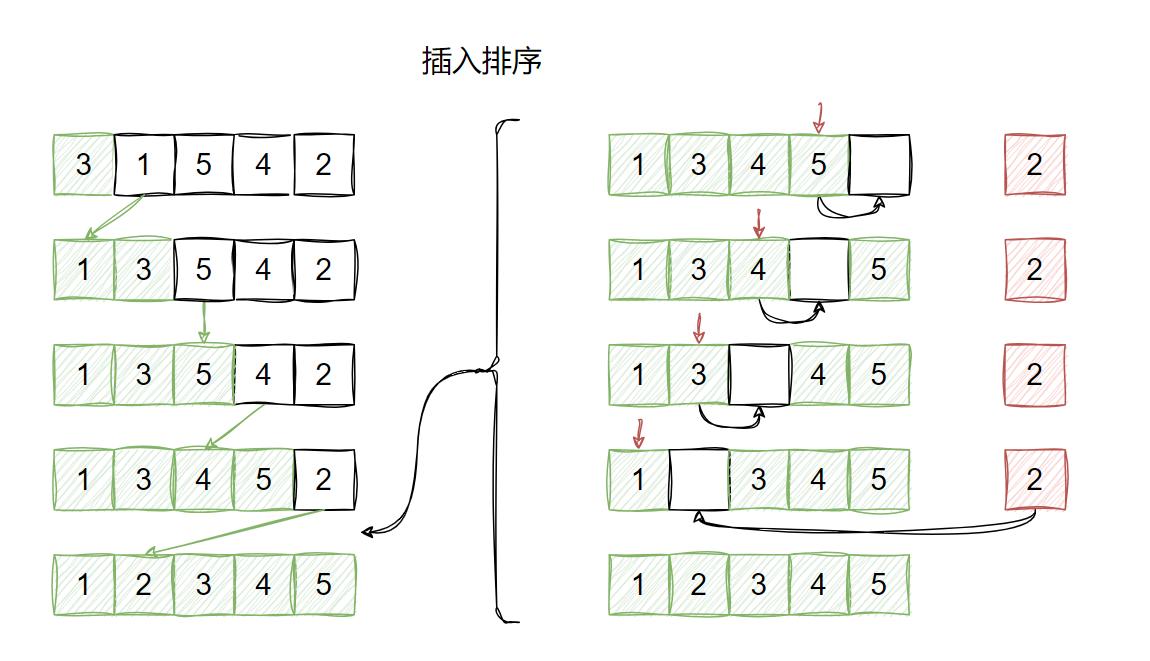
将待排序的数组分为无序区间和有序区间两部分,有序空间在前,无序空间在后。起初,可以认为第一个元素位于有序区间(只有一个元素,一定是有序的),后边所有元素位于无序区间。插入排序的宏观思路是依次从无序区间选择一个元素,插入到有序区间的正确位置,直到无序区间的所有元素都被插入到有序区间。
插入操作的微观逻辑是,选择无序区间的第一个元素作为待插入元素,将其保存到临时变量,然后从有序区间的最后一个元素开始比较,若大于待插入元素,则将其向后移动一位,然后继续和前一位进行比较,直到找到正确的位置,将元素插入即可。
代码实现
1 | def insert_sort(nums): |
复杂度分析
时间复杂度
上述算法共执行 (n-1) + (n-2) + (n-3) + … + 3 + 2 + 1 = 轮循环,每轮循环都执行常量个基本指令,时间复杂度为O(n2)。
空间复杂度
就地排序,使用常数大小的额外空间,空间复杂度为O(1)。
归并排序
算法原理
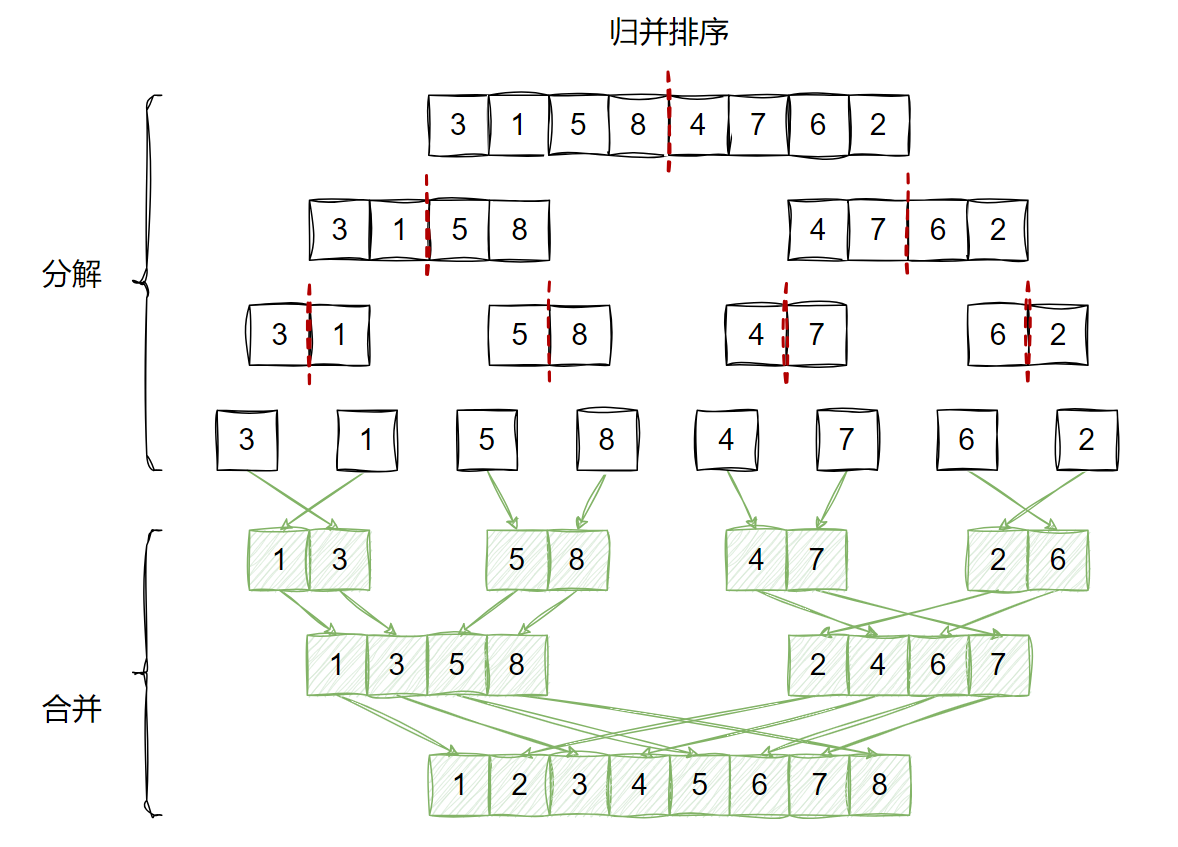
归并排序(Merge Sort)算法的核心是归并操作(Merge)。归并操作指的是将两个已经排好序的列表合并成一个有序列表的操作。
归并操作的核心逻辑十分简单:循环选取两个有序列表各自最小的元素(因为列表本身有序,所以直接取排在最前的元素即可)进行比较,每次都将两者中最小的一个移到临时数组,直到其中一个有序列表被拿空,然后将另一列表中的剩余元素,顺次放入临时数组即可。这样就能将两个有序列表合并为一个有序列表了。
归并排序算法的执行过程分为两个阶段:分解、合并。
分解阶段:不断将数组的排序问题分解为对两个子数组的排序问题,直到子数组中只包含一个元素。
合并阶段:从最小的有序数组(只包含一个数组)开始,逐层进行归并(merge)操作,将两个有序小数组合并为一个有序大数组。
代码实现
1 | def merge(left, right): |
复杂度分析
时间复杂度
该算法的时间复杂度,主要取决于合并操作的循环次数,由于该算法用到了递归,故计算循环次数时,还需要考虑递归调用的总次数。由于每次递归调用都是将数组一分为二,故递归过程可用一个二叉树进行可视化。
例如对一个长度为8的数组进行排序,递归调用层级如下图所示:
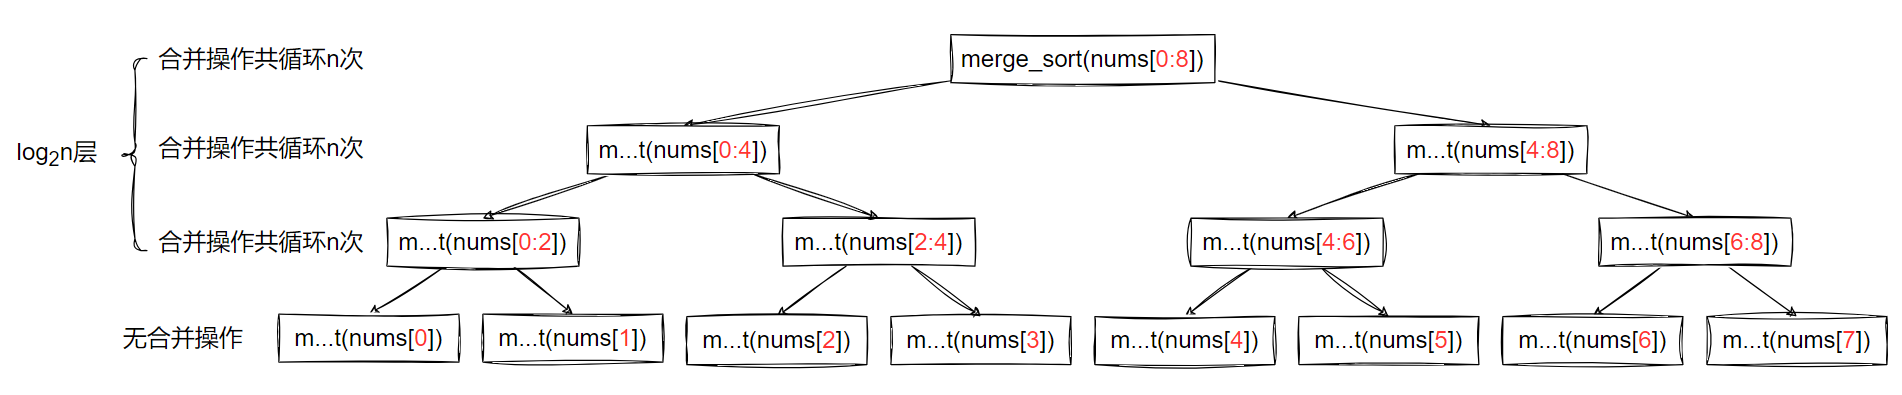
虽然每次递归调用merge_sort()函数,合并操作的循环次数都可能不同,但是不难发现规律,上述递归树中,每层合并操作循环的总次数为n次。所以只需计算出层数,便可得到循环操作的总次数。显然,二叉树的层数level与输入数组长度n的关系为n=2level,因此层数level=log2n。
所以该算法循环执行的总次数为n×log2n(每层循环次数×层数),每次循环操作均执行常数个指令,时间复杂度为O(nlogn)。
空间复杂度
由于每次合并操作都需要创建一个数组来临时存放合并结果,所以空间复杂度主要考虑临时数组占用的空间。虽然每次合并操作都会创建临时数组,但是,这些合并操作并不是同时运行的,每次合并操作结束后,临时数组的空间就会释放。也就是说,该算法在运行时,同一时刻只会有一个临时数组,所有只需考虑最大的临时数组占用的空间即可,显然临时数组的最大长度等于输入数组的长度。因此该算法的空间复杂度为O(n)。
快速排序
算法原理
快速排序算法每次从数组中挑一个元素,作为基准(pivot),然后将所有小于基准元素的元素放置于其左边,将所有大于基准元素的元素放置于其右边,完成后,就相当于完成了按基准元素的划分。同时,原来乱序的数组就也被基准点一分为二,成为两个乱序子数组。之后对两个子数组采用同样的操作划分,直到子数组只包含一个元素。
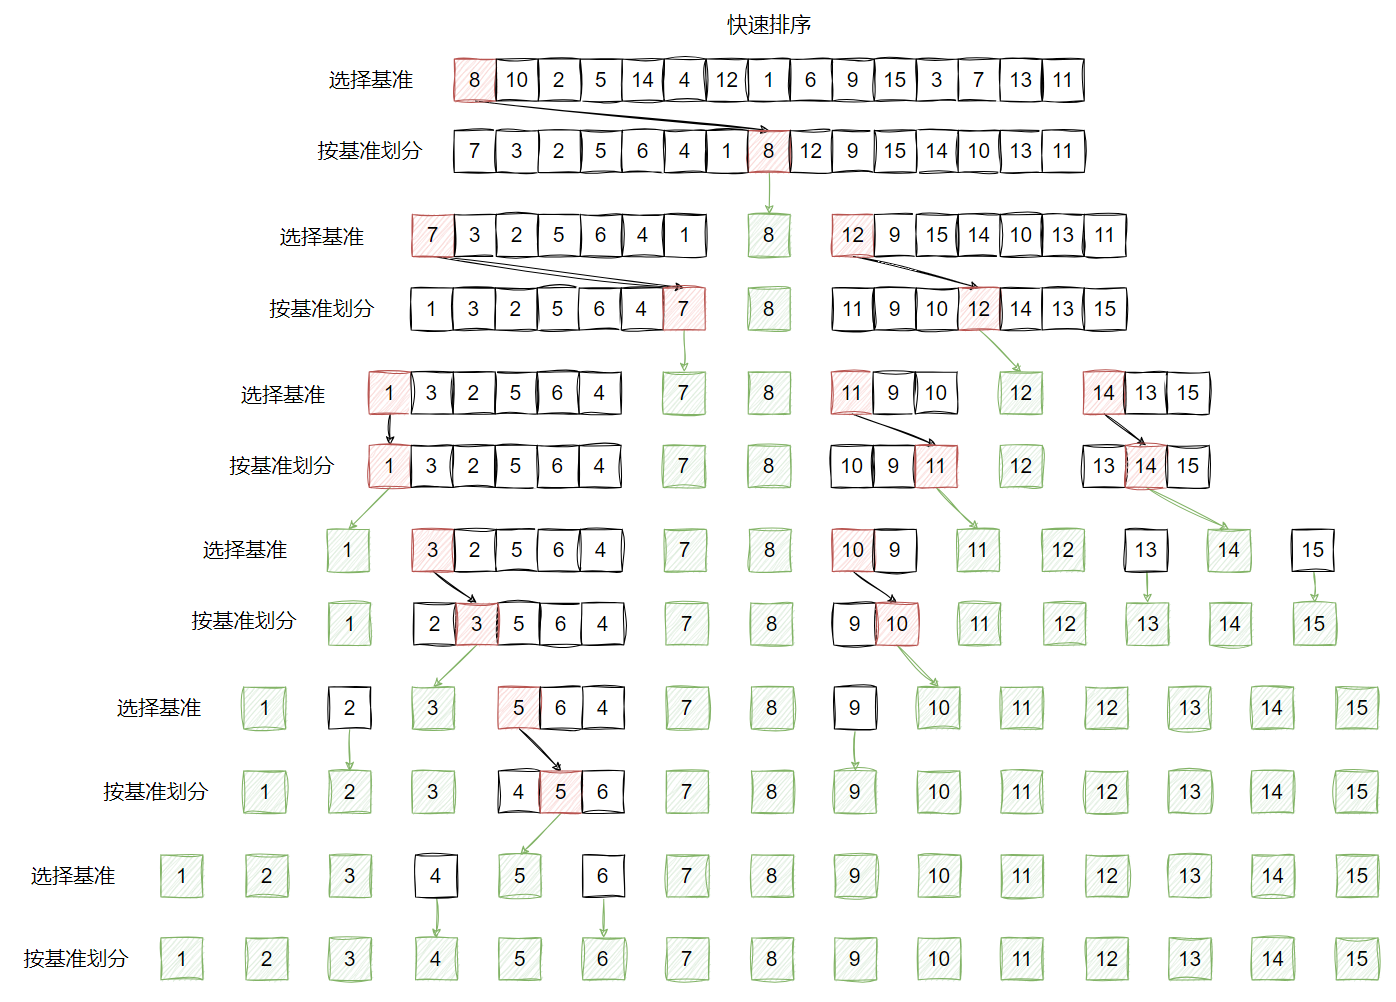
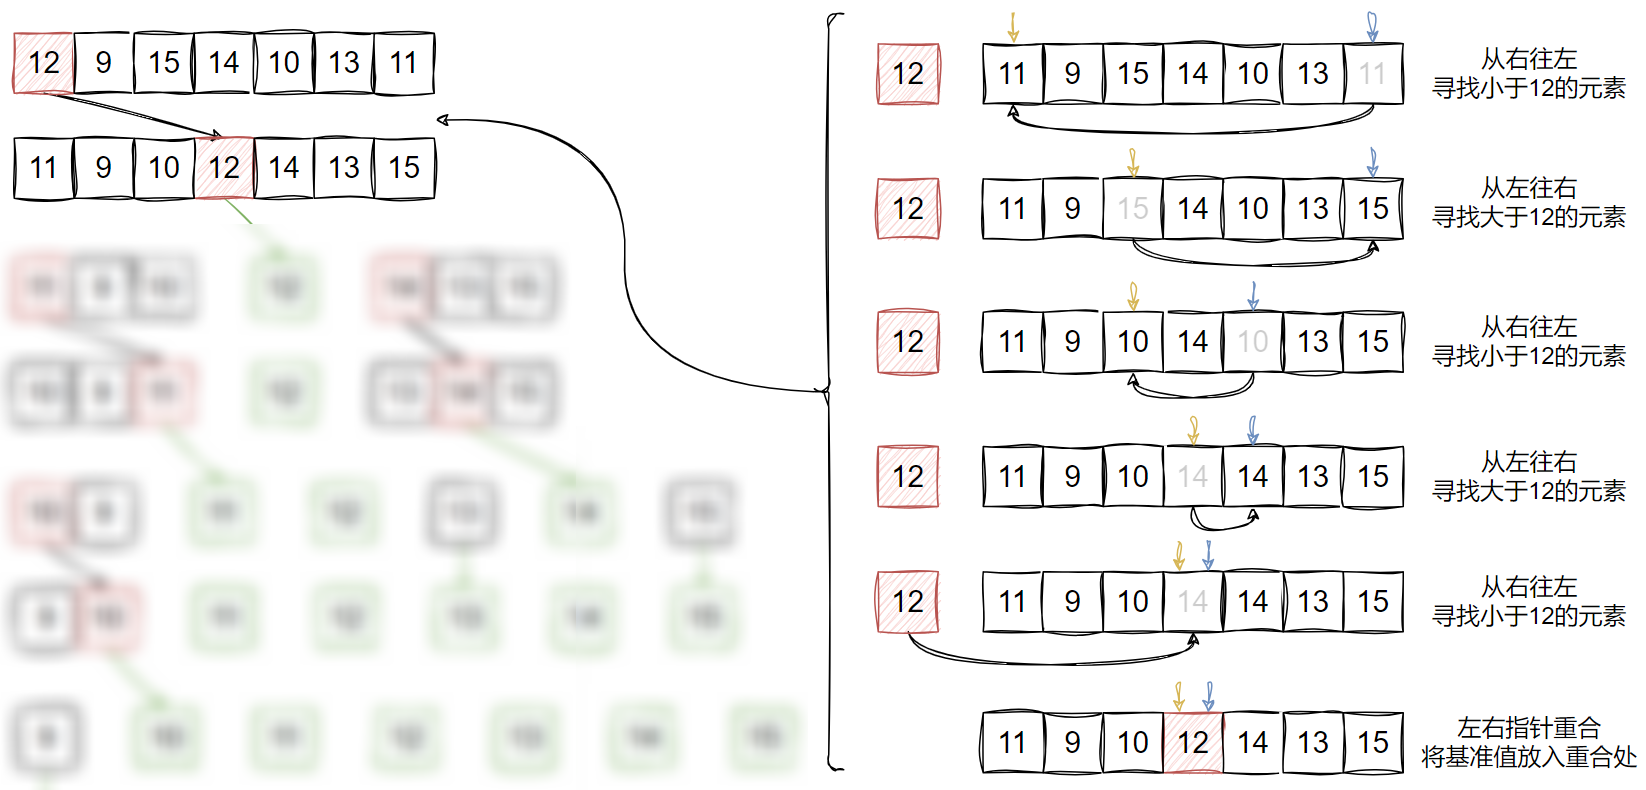
在按基准划分时,先从右到左寻找小于基准的元素,并与基准交换位置;再从左到右寻找大于基准的元素,并与基准交换位置。两者依次交替直到左右指针重合,此时将基准值放在重合处。
代码实现
1 | def partition(nums, left, right): |
复杂度分析
时间复杂度
由于每次递归调用时,pivot的选择会影响到递归调用的总次数,所以该算法的时间复杂度是不固定的。下面分别分析一下最佳和最差两种情况下的时间复杂度。
最佳情况:若每次递归调用时,选择的pivot恰好都是所有数据的中位数,也就是恰好能将数组均匀的一分为二。这种情况下递归调用总次数最少,时间复杂度最低。这种情况下循环总次数约为nlog2n,每次循环都执行常量个基本指令,故时间复杂度为O(nlogn)。
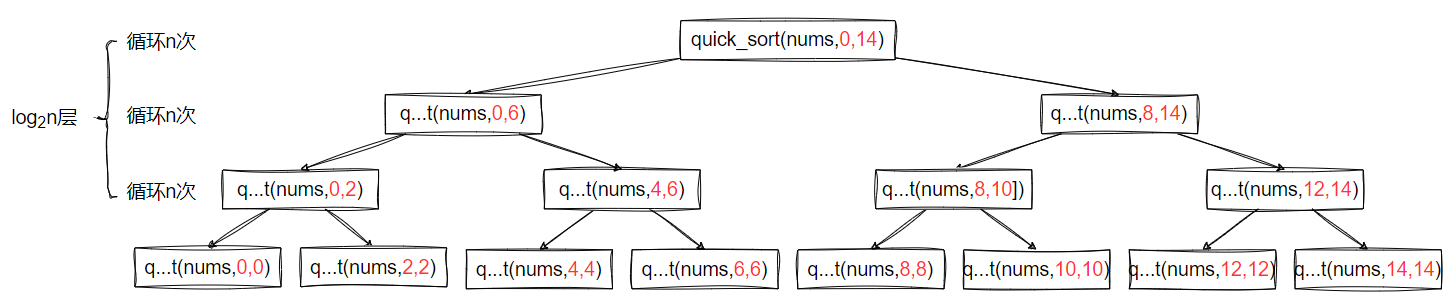
最差情况:若每次递归调用时,选择的pivot都是所有数据的最大值或者最小值,也就是将长度为n的数组分为长度为0和长度为n-1的两个数组。这种情况下递归调用的次数最多,时间复杂度最高。这种情况下循环的总次数为(n-1) + (n-2) + (n-3) +…+ 3 + 2 + 1 = ,每次循环执行常量个基本指令,故时间复杂度为O(n2)。
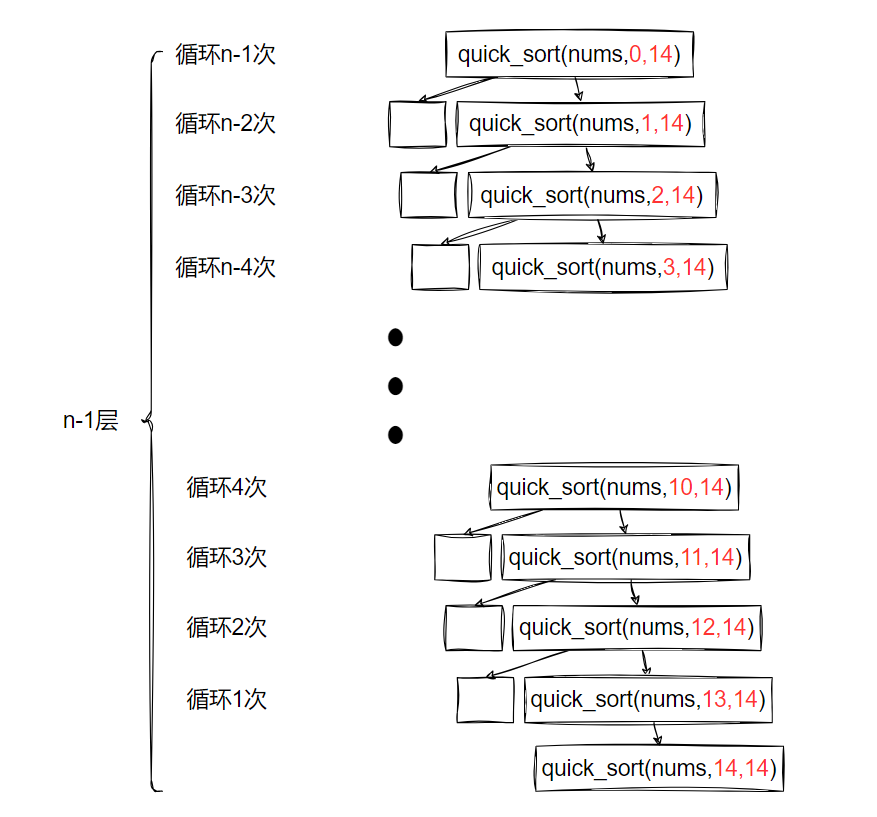
虽然快速排序算法的最差时间复杂度是O(n2),但是这种情况出现的概率很低,除此之外,我们还可以通过某些手段(尽量选取接近中值的pivot),进一步降低最差情况出现的概率,总之我们几乎可以完全避免最差情况的出现。
实际上,更为细致的分析推导与实验统计都一致地显示,在大多数情况下,快速排序算法的平均时间复杂度依然可以达到O(nlogn)。并且由于其真实的T(n)时间函数中,常数系数较小,所以一般情况下,其表现要优于其他算法。
空间复杂度
和时间复杂度相同,空间复杂度也不是固定的。
最佳情况:同时存在的最多的未返回的方法栈数量等于递归树的深度,每个方法栈都只保存常量个变量,所以空间复杂度为O(logn)。
最差情况:同时存在的最多的未返回的方法栈的数量等于n-1,所以空间复杂度为O(n)。
同样,大多数情况下,快速排序法的平均空间复杂度可以达到O(logn)。
堆排序
算法原理
堆排序的基本思想是先将输入的数据构建成一个大顶堆,然后依次将堆顶的元素(即最大元素)移到数组的末尾,之后重新调整堆的结构,并将堆的元素个数减1。重复这一过程,直到所有元素都被排好序。
堆排序的步骤:
构建大顶堆
首先将待排序的序列构建成一个大顶堆。大顶堆的特点是,堆中每个父节点的值都大于或等于其子节点的值,因此根节点是整个堆中的最大值。构建大顶堆时从最后一个非叶节点自底向上依次堆化(非叶节点的计算:数组长度为 n,最后一个非叶节点的索引为 (n // 2) -1)。
交换堆顶和堆底元素
将堆顶元素(即最大元素)与当前堆的最后一个元素交换,堆的大小减1。此时,根节点被替换为堆的最后一个元素,堆的结构被破坏,需要调整堆。
重新调整堆
对堆重新进行堆化,使其满足大顶堆的性质。这样,新的堆顶元素将成为剩余元素中的最大值。此时自顶向下堆化。
重复
重复②③,直到堆的大小为 1。
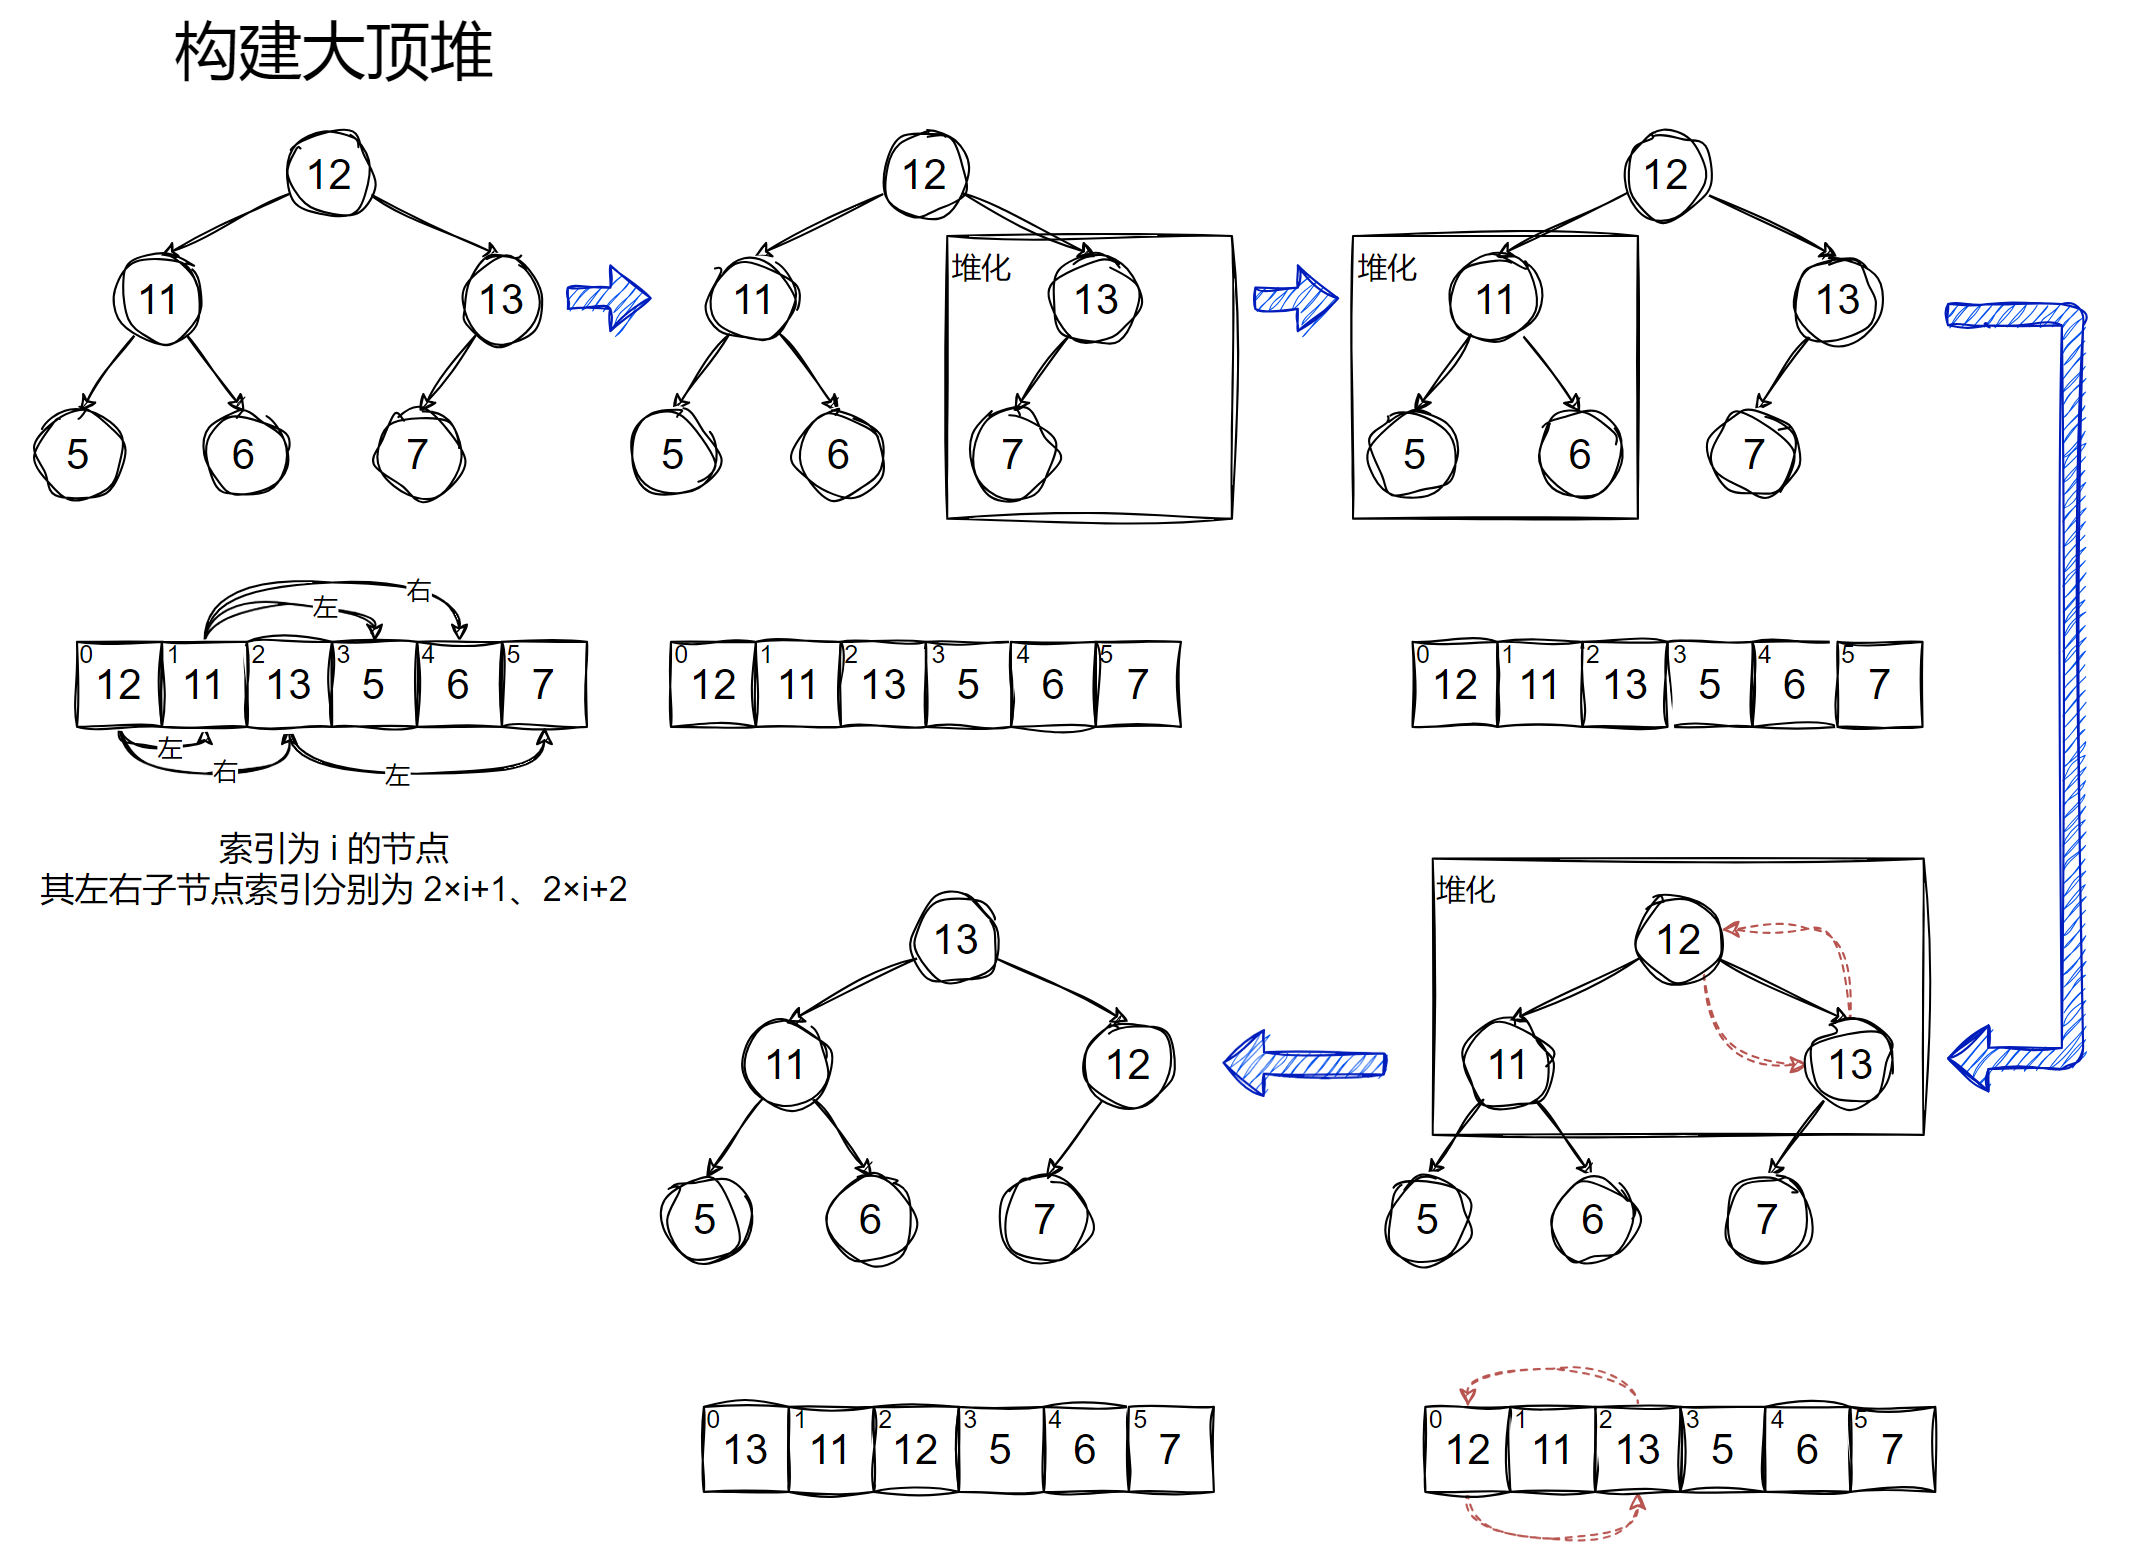
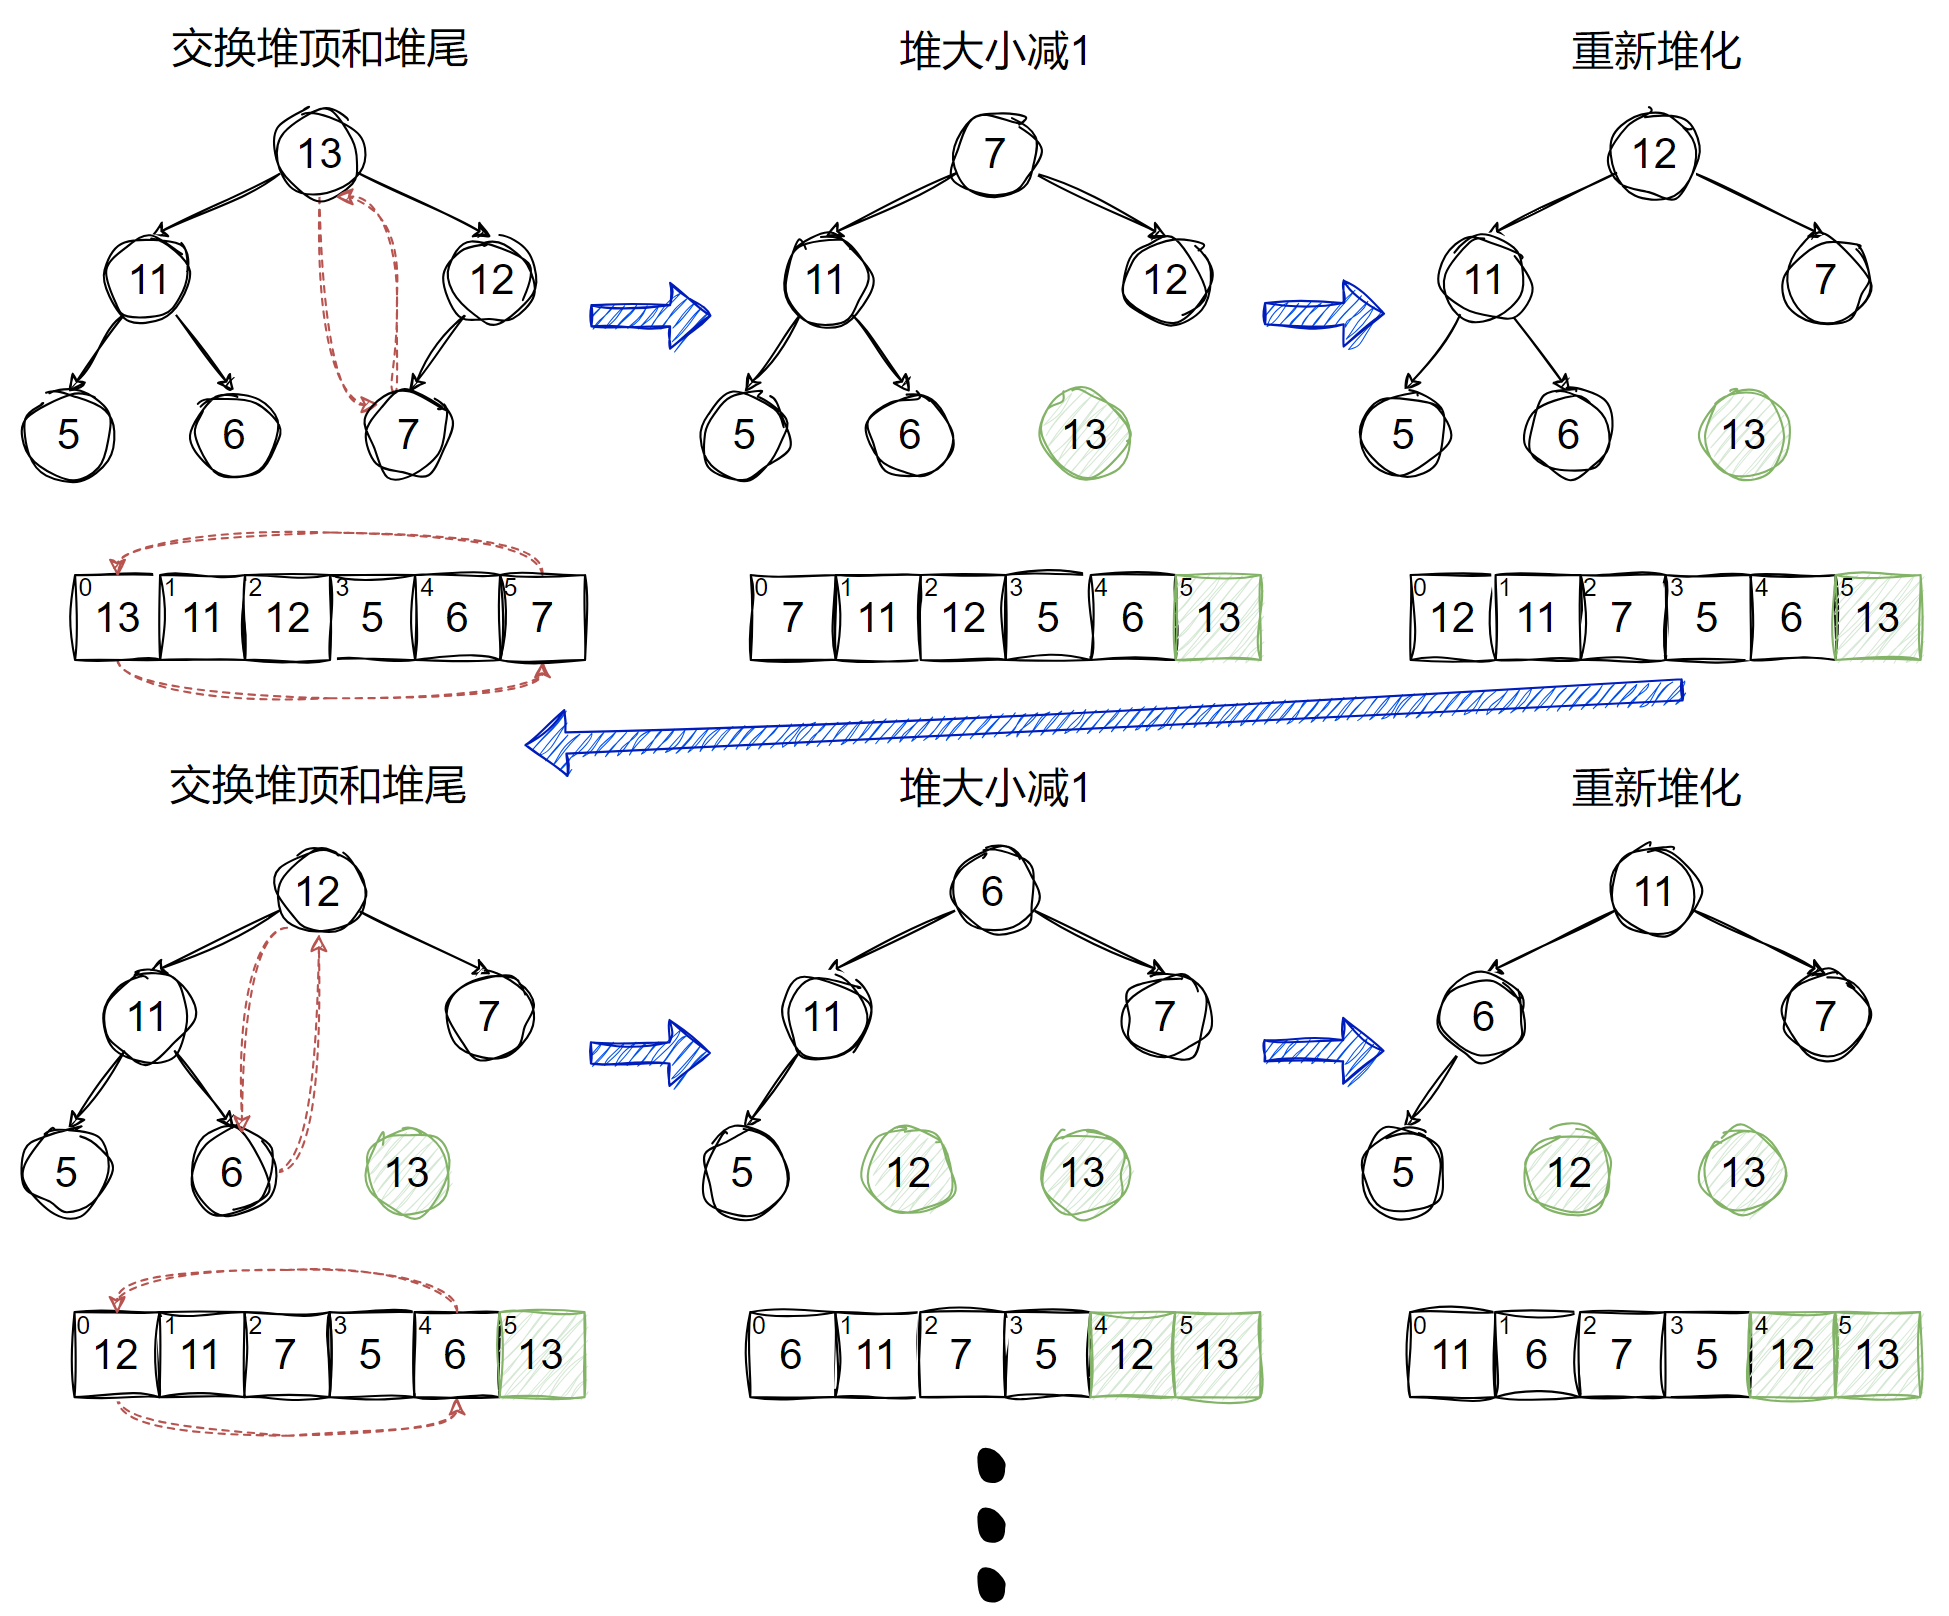
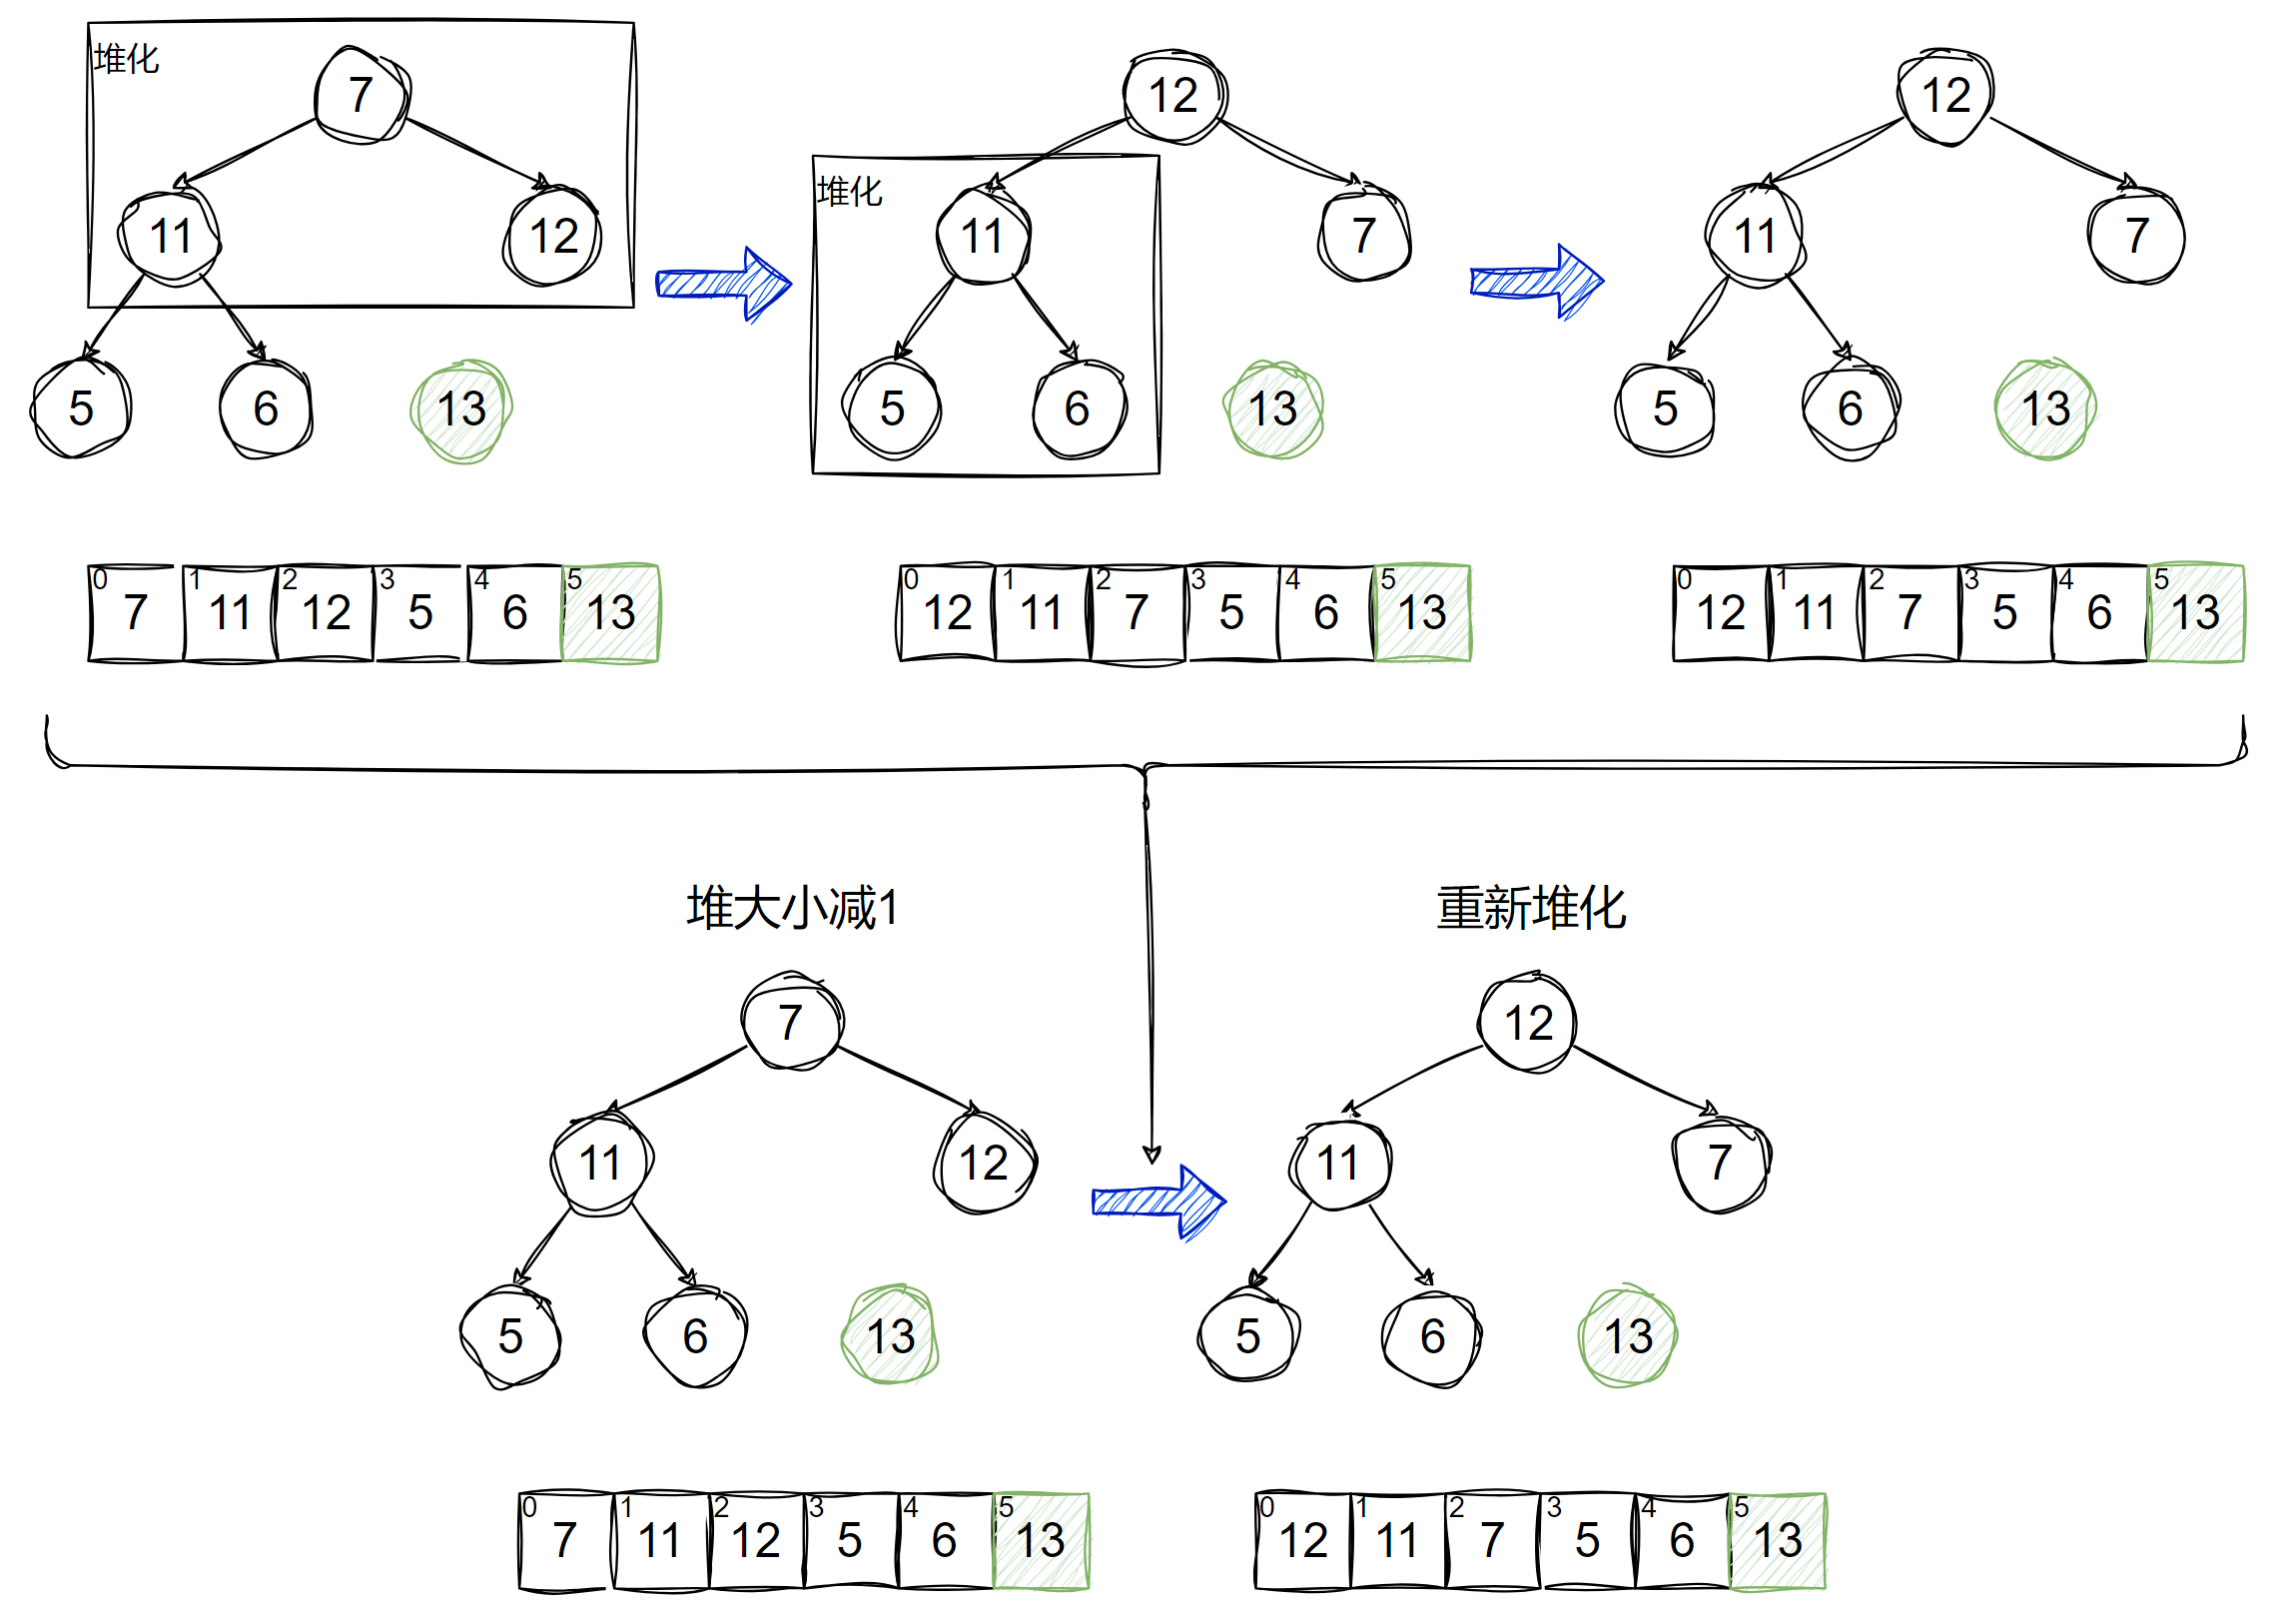
代码实现
1 | #arr 需要进行堆化操作的序列 |
复杂度分析
时间复杂度
其初始构建堆时间复杂度为O(n)。正式排序时,重建堆的时间复杂度为O(nlogn)。所以堆排序的总体时间复杂度为O(nlogn)。
堆排序对原始记录的排序状态不敏感,因此它无论最好、最坏和平均时间复杂度都是O(nlogn)。但是与其他O(nlogn) 的排序算法(如归并排序、快速排序)相比,堆排序的常数因子较大,因此在某些情况下效率较低。
空间复杂度
就地排序,空间复杂度是O(1)。